Les évals ou comment savoir si vos IA font du bon travail
Les évals consistent en l’évaluation ou la notation des réponses générées par les IA ou plus généralement des résultats de leurs actions. Si vous vous apprêtez à faire entrer l’IA dans votre organisation, c’est notamment grâce aux évals que vous saurez si vous êtes en train de gagner du temps ou de l’argent, ou si vous aussi vous êtes victime de l’épidémie d’AI “slop”.
Comme tout concept lié à l’IA, les évals sont passées successivement de garde-fou incontournable à réflexe obsolète “so 2025” (le prompt engineering, vous vous rappelez ?) ; c’est pourtant un outil de référence à utiliser dans certaines situations.
L’éval ou l’interro écrite de l’IA
Très concrètement, dans une éval on va porter un jugement sur une réponse de l’IA. Par exemple, vous pourriez chercher à savoir si votre agent de service client donne des réponses courtes et pertinentes, ou bien pond des romans à la Zola tout en insultant vos utilisateurs. Chaque réponse va ainsi être notée sur une échelle quantitative - une note de pertinence de 1 à 5, ou encore mieux un choix binaire, pertinent / pas pertinent - et / ou qualitative - “pas pertinent car n’a pas compris que l’utilisateur n’était pas encore inscrit au service de covoiturage”. Des scores peuvent être mis en regard du coût en tokens, du temps de réponse, etc.
Ces notes sont comparées entre différents “runs” ou “experiments” (expériences en bon français) afin d’améliorer la qualité des réponses. Les praticiens de l’IA appliquée font essentiellement varier les prompts, le contexte accessible à l’agent, ou le modèle utilisé. Un agent IA sera ainsi “mis en production” s’il atteint une performance satisfaisante pour le coût proposé, par exemple si 75 % des plaintes entrantes sont résolues par l’IA, le reste étant transmis aux vrais humains qui savent gérer les situations difficiles. Les évals peuvent aussi être réalisées de manière continue sur les traces de production pour détecter les dégradations de performance.
L’éval, avec ou sans humain dedans
On distingue plusieurs types d’évals :
-
Les évals “automatiques” : ces évals sont les plus faciles à mettre en place. Elles permettent de noter la réponse générée par l’IA de manière “vérifiable” ou totalement déterministe : par exemple la réponse à un problème de mathématiques, un test d’interface utilisateur automatisé qui échoue ou réussit, une longueur maximale de caractères d’une réponse. Lorsque ces évals sont rapides à calculer, elles sont parfois même intégrées dans le système pour “auto-corriger” l’IA à la volée, c’est la boucle de mesure d’un agent.
-
Les évals “nécessitant un jugement” : ces évals sont les plus laborieuses mais aussi celles qui permettent de “transmettre” un savoir métier particulier à la machine. Elles ont besoin d’un regard extérieur pour apprécier les réponses. Ce regard peut être celui d’un “LLM as a judge” (ou juge LLM) pour les cas les plus simples, notamment en utilisant un LLM plus puissant que le LLM utilisé pour générer la réponse. Et évidemment le regard extérieur peut aussi être celui d’un humain, ce qu’on entend quelquefois par l’expression “Human in the loop”, car l’humain intervient dans la boucle d’évaluation.
Grandeur et décadence des évals
En 2025, les évals étaient présentées comme un préalable indispensable à la mise en place de l’IA, à grand renfort de posts LinkedIn et de formations payantes. Tout le monde devait savoir faire des évals, à commencer par les “product managers” qui coordonnent le processus logiciel en entreprise (réponse : en fait non, c’est une tâche qui se rapproche plutôt de l’expertise des data scientists).
Puis les progrès des modèles ont été si fulgurants que certains métiers, comme celui de développeur, n’ont plus eu besoin d’évaluer les modèles : le code généré était meilleur que celui d’un humain - même après quelques itérations - ou que la génération précédente de Claude ou GPT 4o 4a Terra etc. Pas besoin de prendre 100 fois le train pour se demander si c’est plus confortable que l’avion sur un trajet Paris - Lyon.
Une fois la poussière retombée, qu’en reste-t-il ? À mon sens, les évals restent tout à fait pertinentes pour évaluer l’IA sur des tâches spécifiques à votre organisation, en particulier sur les tâches qui nécessitent une expertise métier.
Comment faciliter les évals par les experts métiers
Noter régulièrement les sorties d’un modèle peut s’apparenter à une tâche titanesque : on peut vite se retrouver avec des milliers de réponses générées par l’IA, entrelacées avec de multiples “tool calls” (appels d’outils, par exemple via le protocole MCP). L’interface des logiciels d’aide à l’éval et à l’observabilité des modèles comme Arize Phoenix ou LangSmith peut vite ressembler à ça :
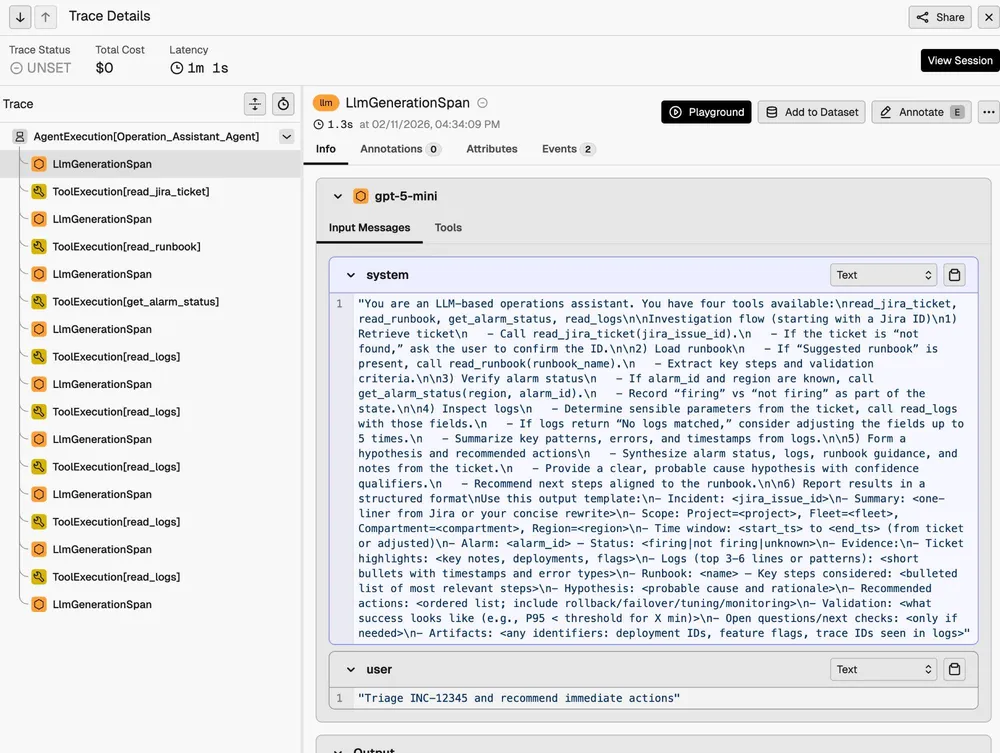
Une seule trace d’agent dans Arize Phoenix : une quinzaine d’appels au LLM et aux outils s’enchaînent avant d’arriver à la réponse finale. Source : Arize AI.
Il est dès lors laborieux de noter une telle quantité d’information, surtout quand on a besoin de documents externes pour vérifier les réponses (comme le PDF source d’un RAG par exemple).
La solution vous est donnée par les LLM eux-mêmes : il est beaucoup plus efficace, au moins pour la partie notation humaine, de faire générer par un LLM une interface personnalisée dont l’objectif est de faciliter la notation humaine. Vous pouvez ainsi mettre cette appli interne entre les mains de vos experts métiers pour recueillir les notes, pour ensuite les réintégrer dans votre pipeline d’expérimentation et d’apprentissage. En voici un exemple pour évaluer les demandes de subventions des particuliers pour leurs travaux de rénovation énergétique :
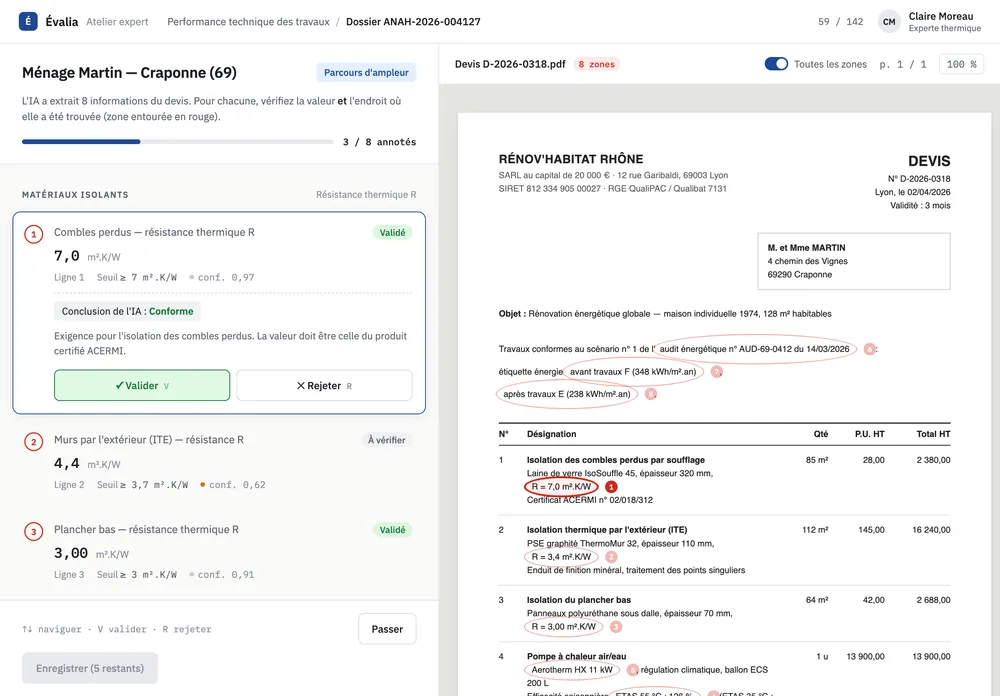
Interface interne d’évaluation : l’expert métier note les analyses IA des demandes de subvention, en ayant sous les yeux le document source et la réponse de l’IA.
En conclusion, continuez les évals, elles restent un indicateur essentiel de la performance de votre système IA, mais automatisez ce qui peut l’être, concentrez vos efforts sur l’expertise métier de votre équipe et rendez la vérification humaine la plus fluide possible.
Vous avez un projet ? Parlons-en !
Je peux vous accompagner dans la mise en place de la boucle complète d’évaluation et d’optimisation des modèles IA, ainsi qu’à la création d’interfaces personnalisées pour faciliter la notation humaine. Au plaisir d’échanger !